
 Notícias
Em 28 de outubro, o Supabase abriu ao público a beta do OrioleDB, um motor de armazenamento alternativo para PostgreSQL. Ele foi pensado para tabelas que recebem muitas atualizações e exclusões, nas quais o mecanismo tradicional pode acumular versões antigas de linhas e exigir manutenção frequente. A novidade é relevante para equipes que já avaliam o Supabase ou mantêm aplicações em Postgres, mas há um limite decisivo: a própria empresa diz que a beta ainda não está pronta para produção. Portanto, a resposta prática hoje é testar com dados não críticos e medir o próprio workload — não migrar um sistema em uso.
O que o OrioleDB tenta resolver
No PostgreSQL tradicional, uma atualização normalmente grava uma nova versão da linha; a versão anterior permanece no armazenamento até que o VACUUM a recupere. Em tabelas de pedidos, filas de tarefas, sessões ou estoque, com alterações constantes, esse processo pode aumentar o volume de dados e de índices e pressionar consultas e manutenção. Não significa que todo banco PostgreSQL tenha esse problema: o impacto varia com o padrão de escrita, os índices, o tamanho dos dados e a configuração.
O OrioleDB muda a forma como essas linhas são guardadas. Em vez de manter versões mortas no heap — a estrutura de armazenamento padrão do Postgres —, ele usa um undo log para registrar versões anteriores e organizá-las para recuperação. As linhas também ficam integradas à estrutura do índice primário. Segundo a explicação técnica publicada pelo Supabase em 28 de outubro, isso pode reduzir o trabalho de VACUUM e algumas escritas de índice em tabelas frequentemente modificadas. O projeto usa a interface de armazenamento conectável do PostgreSQL, descrita na documentação oficial do PostgreSQL.
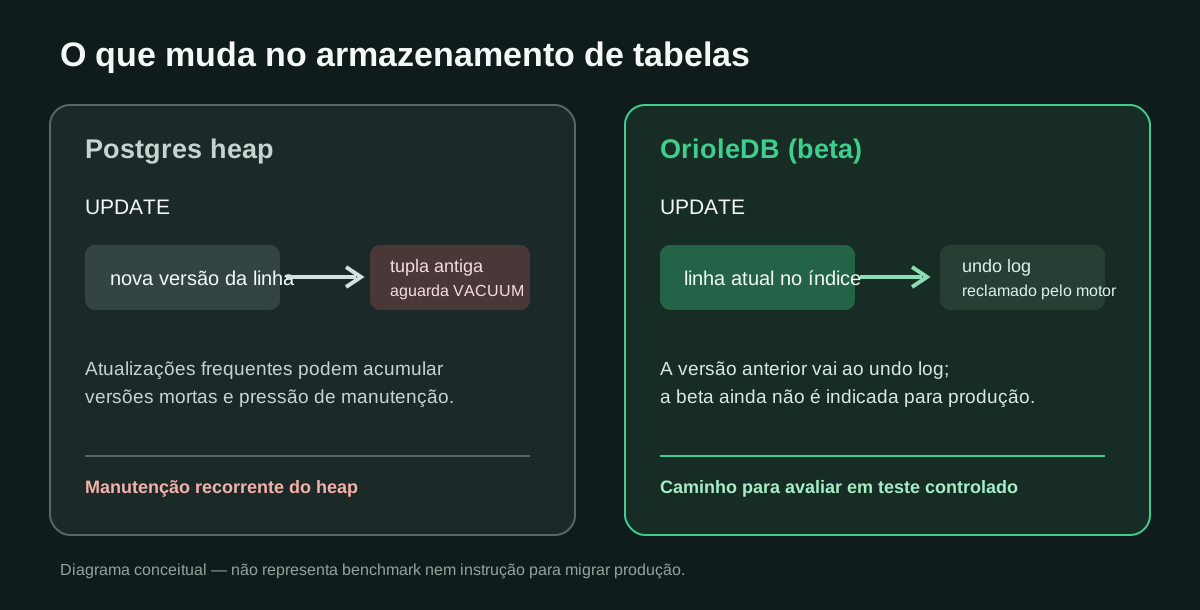
No modelo de heap, a equipe pode precisar acompanhar o acúmulo de versões antigas e ajustar o processo de limpeza. No OrioleDB, a versão anterior segue para o undo log e é recuperada pelo mecanismo. Essa diferença não garante, por si só, que uma aplicação fique mais rápida: consultas, concorrência, índices e limites do serviço continuam influenciando o resultado.
Os ganhos anunciados precisam de contexto
O Supabase relata até 1,8 vez mais transações por minuto em um teste de carga baseado no TPC-C, comparando a beta com seu Postgres padrão em uma configuração de 8XL. A ressalva também está na fonte: o teste é derivado do TPC-C, mas não cumpre todos os requisitos do benchmark oficial e, por isso, não deve ser tratado como um resultado TPC-C comparável. O DBArena publica a metodologia, os dados brutos e comparações de custo e desempenho, para que equipes possam conferir as condições do teste.
Na mesma publicação, o Supabase informa que a diferença foi menor quando os dados cabiam na memória e que o Postgres tradicional chegou a vencer em uma das configurações menores. O maior potencial aparece, segundo a empresa, em tabelas com muitas atualizações ou exclusões, conjuntos maiores que a memória, alta concorrência e buscas frequentes pela chave primária. São hipóteses para selecionar um teste, não uma promessa de desempenho para qualquer app.
Esse tipo de escolha faz parte da arquitetura do produto. Nosso guia sobre como escolher uma stack de tecnologia explica por que decisões de infraestrutura dependem dos requisitos do sistema, e o artigo sobre quando vale a pena desenvolver software sob medida ajuda a enquadrar a decisão no custo e na operação do produto inteiro.
O que impede uma migração agora
A documentação da beta lista limites que afetam decisões concretas. O projeto OrioleDB é escolhido ao criar um novo projeto no Supabase; não é possível simplesmente ativar o motor em um projeto existente ou removê-lo depois. A beta não oferece SLA nem recuperação point-in-time (PITR), e a restauração de backup em um novo projeto também não está disponível. Isso torna inadequado usá-la como banco de produção para uma aplicação que depende dessas garantias.
Há outras diferenças de compatibilidade: índices B-tree são o caminho mais maduro; outros tipos de índice, incluindo pgvector HNSW, passam por uma ponte experimental. Alguns comandos e extensões não estão disponíveis e há diferenças de comportamento em transações SERIALIZABLE. A documentação atual do Supabase sobre OrioleDB reúne as limitações e instruções de teste. Antes de qualquer prova de conceito, compare essa lista com as consultas, extensões, rotinas de backup e requisitos de recuperação do seu app.
O anúncio também tem um vídeo oficial curto que apresenta a beta. Ele ajuda a entender a proposta, mas não substitui a documentação nem os testes de compatibilidade:
Como avaliar sem colocar clientes em risco
Se a sua aplicação sofre com tabelas muito atualizadas, comece medindo antes de trocar tecnologia: volume de atualizações e exclusões, crescimento de tabelas e índices, duração de VACUUM, latência p95, concorrência e custo mensal. Escolha uma cópia representativa dos dados — sem informações sensíveis desnecessárias — e rode consultas e rotinas reais em um projeto de teste separado. Compare a mesma configuração e o mesmo conjunto de dados com heap e OrioleDB, registrando também os erros e o esforço de operação.
Teste ainda o caminho de recuperação, os índices usados, tarefas em lote e comportamento da aplicação sob carga. Se sua equipe depende de PITR ou de restauração rápida, a ausência dessas opções na beta já é motivo para não colocá-la no caminho crítico. E se o workload é predominantemente de leitura, cabe na memória e não apresenta sinais de bloat, talvez o ganho seja pequeno demais para justificar uma nova variável.
OrioleDB é uma novidade técnica promissora para investigar uma classe específica de gargalos no Postgres. Em 30 de outubro de 2026, porém, o uso responsável é tratá-lo como experimento de engenharia: entender o problema, reproduzi-lo em teste e esperar por maturidade operacional antes de considerar produção.
