
 Apps
Se seu app Android executa modelos de aprendizado de máquina no próprio aparelho, a atualização de LiteRT para o Google Play services pode reduzir o tamanho do pacote e facilitar a chegada de melhorias de desempenho sem uma nova versão do app. O Google anunciou em 28 de outubro de 2026 suporte à GPU com o mecanismo ML Drift e à nova API CompiledModel. Em testes da própria empresa, apps que migraram ficaram cerca de 8 MB menores e a inferência na GPU foi aproximadamente 1,4 vez mais rápida que com o antigo delegate do TensorFlow Lite. São resultados divulgados pelo Google, não uma garantia para todo modelo ou celular.
A mudança vale principalmente para equipes que distribuem apps Android pela Google Play, usam modelos próprios no formato .tflite e querem executar visão computacional ou outras tarefas de IA localmente. Ela não torna qualquer modelo mais rápido por mágica: é preciso avaliar compatibilidade, dispositivos do público e resultados reais antes de trocar o runtime.
O que muda dentro do app
Antes, uma equipe podia incluir uma cópia do runtime de inferência no próprio APK ou AAB. Com LiteRT no Google Play services, o runtime é entregue como um componente compartilhado, enquanto o app mantém o modelo e chama a API. O anúncio técnico do Google diz que, nos testes da empresa, remover a biblioteca empacotada reduziu o aplicativo em cerca de 8 MB. Para usuários, isso pode significar menos dados no download e menos armazenamento ocupado quando vários apps usam o mesmo runtime.
O desenho também separa o ciclo de atualização: melhorias, correções e atualizações de segurança do runtime podem chegar por meio do Play services, sem esperar uma nova publicação do app. Isso diminui trabalho de distribuição, mas transfere parte do controle para a plataforma. Se o produto precisa congelar uma versão específica do motor de inferência para manter comportamento reproduzível, ou precisa funcionar em aparelhos sem Google Play services, essa conveniência pode não compensar.
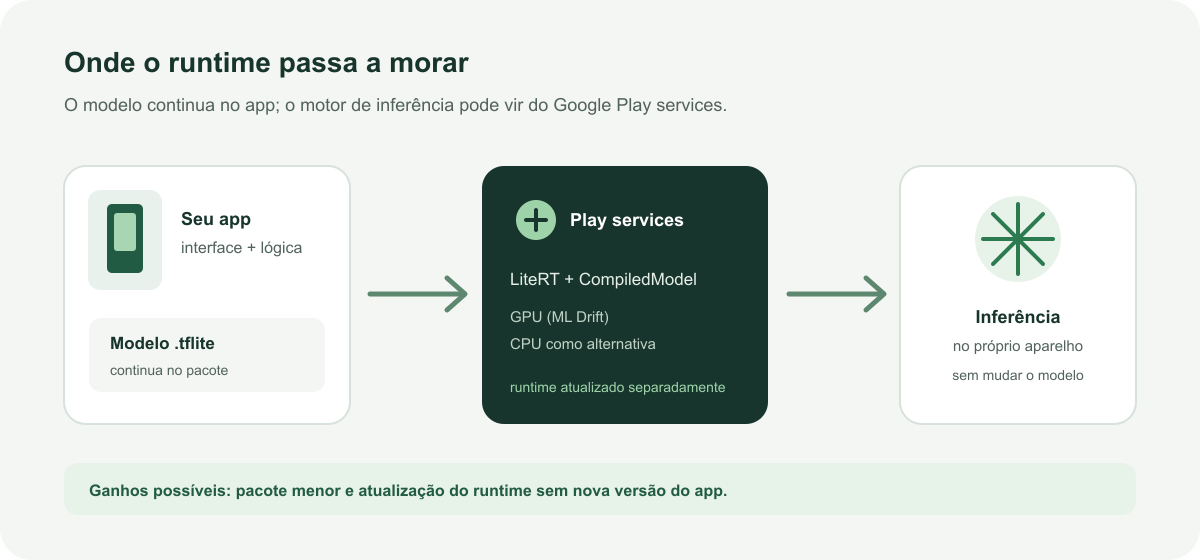
A principal mudança de programação é a API. O Google recomenda o CompiledModel, sucessor moderno do Interpreter, para a nova aceleração de GPU. O modelo .tflite pode continuar o mesmo, mas inicialização, criação do ambiente de inferência e execução precisam seguir o novo caminho. A documentação Android para executar CompiledModel pelo Play services explica as diferenças: trocar a dependência, inicializar o ambiente disponibilizado pelo Play services e habilitar a GPU explicitamente.
GPU com alternativa de CPU: planeje a experiência
O CompiledModel tenta usar GPU quando ela está disponível e é compatível com a operação. A documentação descreve fallback para CPU quando o dispositivo não tem uma GPU utilizável; a equipe ainda precisa implementar e testar esse fluxo corretamente. Também é necessário medir o tempo completo da operação: o envio do trabalho à GPU pode retornar antes de a execução e a leitura dos resultados terminarem. Medir só a chamada de inferência pode produzir uma comparação enganosa.
O número de 1,4 vez citado pelo Google é uma referência de seus testes com o ML Drift contra o antigo delegate de GPU. Desempenho real depende do modelo, das operações usadas, da GPU, do aquecimento inicial e do custo de transferir dados entre CPU e GPU. Um modelo pequeno pode não ganhar velocidade; uma rede com operadores sem suporte pode exigir execução parcial ou CPU. Por isso, registre tamanho do app, latência percebida, consumo de memória, aquecimento e qualidade da saída em uma amostra de aparelhos que represente seus clientes.
Há outro ponto de calendário: o Google afirma que o antigo delegate de GPU deixa de receber novos recursos e recomenda migrar para o CompiledModel. O aviso é um motivo para planejar, não para fazer uma troca apressada em produção. A orientação de migração do Interpreter para CompiledModel recomenda comparar saídas com uma entrada conhecida e remover dependências antigas para evitar classes duplicadas. O caminho antigo ainda pode ser adequado enquanto a equipe valida o novo.
Quando o runtime do Play services não serve
A escolha não é universal. O runtime hospedado no Play services depende desses serviços no aparelho. Se o app também atende dispositivos sem Google Play services ou é distribuído em outra loja, o runtime empacotado pode dar cobertura mais consistente. A documentação recomenda manter o runtime incluído no app quando a equipe precisa de NPU, operadores personalizados ou classes de suporte sem substituto compatível. Ela também aponta a opção empacotada para quem precisa escolher quando atualizar a versão do runtime.
Para uma migração, comece pelo inventário: versão atual do TensorFlow Lite ou LiteRT, delegates e operadores do modelo, APIs de pré e pós-processamento, versões mínimas do Android e canais de distribuição. Depois faça uma prova de conceito em uma branch. Compare a saída do modelo antigo com a nova usando entradas fixas, teste dispositivos com e sem GPU adequada e valide o comportamento quando a inicialização do Play services falha. O modelo pode ser idêntico enquanto o ambiente de execução e o caminho de aceleração mudam.
Se a equipe estiver escolhendo entre app nativo, híbrido e PWA, essa decisão vem antes: IA executada no aparelho pode ser uma exigência de privacidade, resposta imediata ou uso offline, mas não deve ser adicionada apenas porque há um novo runtime. O guia da Pump sobre como escolher entre app nativo, híbrido ou PWA ajuda a estruturar esse tipo de trade-off. E, quando a experiência Android depende de conectar serviços a assistentes, veja também o artigo sobre apps Android acionados pelo Gemini, que trata de outra integração da plataforma e de seus limites atuais.
Um piloto pequeno responde às perguntas certas
O anúncio é relevante para apps que já rodam modelos próprios localmente, sobretudo quando o tamanho do pacote ou a atualização do runtime são problemas concretos. O passo prudente é selecionar um fluxo de uso, medir a versão atual e testar CompiledModel em aparelhos de diferentes faixas. Só então decida se o ganho medido justifica atualizar as dependências e assumir o ciclo de runtime do Play services.
Não compare apenas números do benchmark. Verifique se a latência melhora na tarefa que importa para a pessoa usuária, se a saída continua equivalente, se a inicialização cabe no fluxo de tela e se o aplicativo ainda funciona nos canais de distribuição prometidos. O resultado pode ser um app menor e mais rápido; a confirmação, porém, vem da medição no produto e nos dispositivos reais do público.
