
 IA
A Microsoft colocou em prévia pública um caminho de treinamento de modelos em que a equipe escreve o loop de aprendizagem em Python e a infraestrutura do Foundry executa o trabalho nas GPUs. Para empresas que precisam adaptar um modelo aberto a uma tarefa específica, a novidade promete mais controle sobre a receita de treinamento sem exigir que a equipe opere sozinha toda a infraestrutura. Há, porém, um limite importante para projetos brasileiros: a documentação consultada em 30 de outubro não lista a região Brazil South como compatível com Programmed Training. Portanto, o recurso merece um piloto técnico, mas não deve entrar em um plano de produção ou de residência local sem checar modelo, região e modalidade disponíveis.
O que a Microsoft anunciou
Em 29 de outubro de 2026, a Microsoft apresentou o Programmed Training no Microsoft Foundry como uma prévia pública. Segundo o anúncio oficial, o serviço oferece uma API Python para que desenvolvedores descrevam receitas próprias de treinamento; o código define o loop e o Foundry fornece a execução com GPUs.
Isso abre uma opção intermediária entre usar o modelo sem ajustes e assumir toda a operação de treinamento em infraestrutura própria. A equipe mantém a lógica do processo — por exemplo, a sequência de etapas e critérios que fazem sentido para seu caso — enquanto delega parte da execução da infraestrutura à plataforma. O anúncio é sobre a capacidade de programar a receita, não uma promessa de que qualquer modelo, método ou carga de trabalho esteja disponível.
A página de modelos vendidos pelo Azure no Foundry separa Programmed Training de Managed Training e lista, por modelo, quais métodos e opções de implantação são compatíveis. Essa matriz é mais útil do que assumir que a novidade funciona para todo item do catálogo: suporte a treinamento, escolha de região e forma de servir o modelo são decisões relacionadas, mas distintas.
O que isso muda para um produto digital
A customização pode fazer sentido quando um modelo genérico erra repetidamente em um padrão de saída, vocabulário ou tarefa delimitada, mesmo depois de bons exemplos no prompt. Um time pode então comparar alternativas: melhorar instruções e recuperação de dados, usar um serviço gerenciado de ajuste ou testar uma receita codificada de treinamento. A decisão depende de uma avaliação com exemplos representativos, não apenas de uma demonstração visualmente convincente.
Esse caminho interessa sobretudo a equipes que já têm dados revisados, uma métrica objetiva e capacidade de experimentar com Python e aprendizado de máquina. Um site institucional ou um aplicativo simples que só precisa responder perguntas sobre conteúdo atualizado provavelmente deve primeiro avaliar busca com fontes, boas instruções e uma API de inferência. Treinar um modelo traz custo, preparação de dados, avaliação e manutenção da versão; não é uma etapa obrigatória para “colocar IA” em um produto.
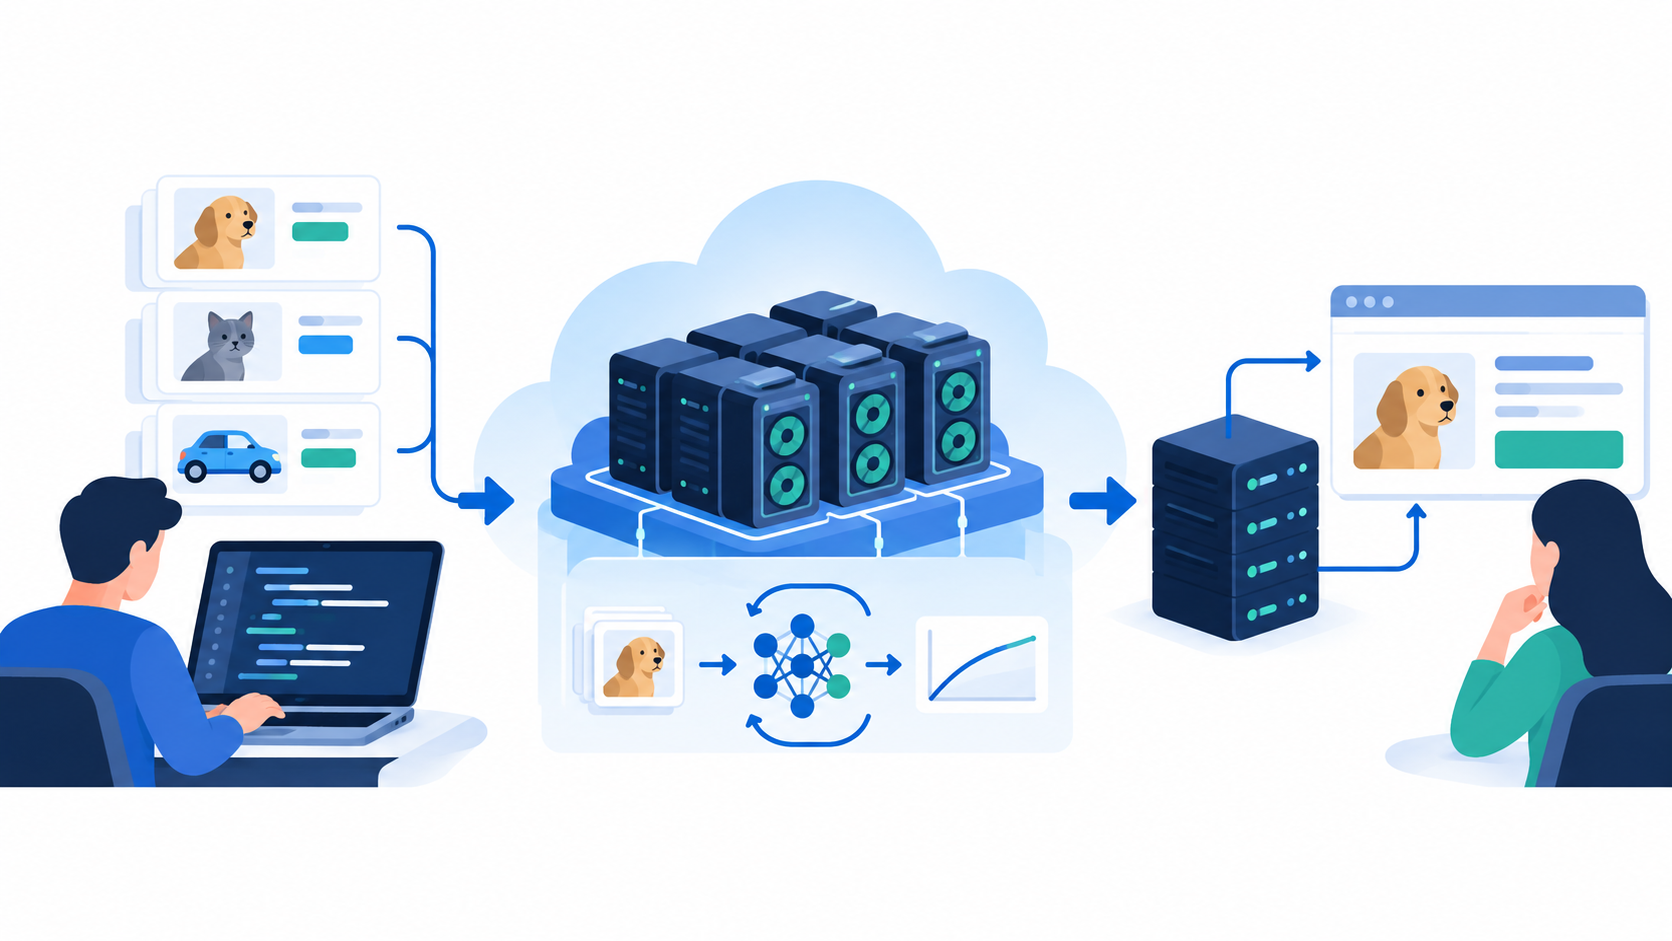
Fluxo ilustrativo, não arquitetura oficial da Microsoft: dados e receita de treinamento, execução computacional, avaliação e integração por API.
Para decidir se customização é mesmo necessária, vale retomar o guia da Pump sobre IA generativa nas empresas: onde ajuda e o que exige cuidado. E, quando o modelo treinado estiver pronto, ele ainda precisa ser integrado a um produto: nosso artigo sobre o que é uma API e quando uma empresa precisa de integração ajuda a separar treinamento de disponibilização do serviço.
A ressalva prática: a região brasileira
A lista de regiões da documentação atual indica que Programmed Training não está disponível em Brazil South. A mesma página diferencia essa disponibilidade da de Managed Training, que aparece para a região com restrições por modelo. Isso não significa que todo caminho de customização esteja indisponível no Brasil; significa que não se deve presumir equivalência entre as modalidades. Para workloads com requisito de residência, a equipe precisa confirmar em qual local os dados de treinamento e a computação serão processados, qual variante de treinamento é aceita e quais modelos podem ser usados.
A Microsoft também classifica a capacidade anunciada como prévia. Em recursos de prévia, comportamento, interfaces e compatibilidade podem mudar; a empresa recomenda validar as condições específicas antes de adotar recursos de prévia em cargas críticas. A documentação de fine-tuning no Foundry mostra que a personalização envolve preparar dados de treinamento e validação, escolher um modelo compatível, executar o job e medir o resultado antes da implantação. Esses passos continuam valendo mesmo quando a receita é escrita em código.
Como avaliar sem assumir risco desnecessário
Um piloto útil começa com uma pergunta delimitada: qual erro observável do modelo atual a equipe espera reduzir? Monte um conjunto pequeno, mas representativo, de exemplos e uma linha de base. Compare a solução atual com prompt e recuperação, o treinamento gerenciado já disponível e a nova receita programada. Registre qualidade, latência, custo total e comportamento em exemplos que não entraram no treinamento.
Use dados sintéticos ou anonimizados na primeira rodada. Antes de enviar dados reais, confira permissões, retenção, localização de processamento e termos aplicáveis ao serviço. A lista de modelos e opções no Foundry lembra que compatibilidade, disponibilidade e ciclo de vida variam entre modelos; por isso, anote o identificador exato e a região do projeto junto ao resultado do teste.
Também é importante separar a aprovação do experimento da aprovação de produção. Defina quem pode iniciar jobs, como registrar versões de dados e código, quem avalia resultados e como reverter para o modelo anterior. Se a empresa depende de processamento em uma região específica, confirme esse requisito antes de investir tempo na implementação: para Programmed Training, a tabela consultada ainda não inclui Brazil South.
O que ainda não sabemos
A Microsoft anunciou uma prévia de capacidade e documentação técnica, não uma comparação independente de desempenho, custo ou qualidade contra outras formas de ajuste. A novidade não prova que um modelo personalizado será mais preciso para qualquer negócio nem que o trabalho será mais barato do que melhorar prompts e dados. A região Brazil South ausente da matriz é uma restrição concreta a confirmar no momento do projeto, pois disponibilidade de prévia pode mudar.
Para clientes e prospects da Pump, a notícia vale como sinal de que plataformas de nuvem estão abrindo mais controle sobre a customização de modelos. O passo responsável é testar um caso de uso estreito, com critérios mensuráveis e dados seguros, e só então decidir se o ganho justifica a complexidade adicional.
