
 Notícias
O anúncio de 20 de outubro aproxima o PyTorch das TPUs do Google: equipes podem executar modelos PyTorch com o runtime TorchTPU e servir modelos abertos por meio de backends de vLLM e SGLang. Para tráfego distribuído, o projeto llm-d 1.0 adiciona roteamento e coordenação de réplicas em Kubernetes. Isso amplia a escolha de infraestrutura, mas não torna uma TPU automaticamente mais barata nem elimina o trabalho de adaptar e validar cada modelo.
O que foi lançado
No PyTorch Conference, o Google publicou o TorchTPU como software de código aberto e anunciou integrações com ferramentas conhecidas por equipes de IA. O comunicado do Google Cloud, de 20/10/2026, apresenta a biblioteca como um backend PyTorch nativo para seus aceleradores. O anúncio técnico do Google Developers Blog detalha os backends criados em parceria com Inferact, responsável pelo vLLM, e RadixArk, ligado ao SGLang.
Na prática, as equipes passam a ter um caminho PyTorch para testar e servir alguns modelos abertos em TPU, sem reescrever toda a definição do modelo para outro framework. O TorchTPU oferece execução interativa e integração com torch.compile; os backends mantêm partes conhecidas do vLLM e do SGLang, como os servidores de API, enquanto usam o runtime e kernels específicos de TPU por baixo. Isso reduz uma barreira de entrada, mas não significa que toda operação, modelo ou configuração de GPU seja compatível sem mudanças.
Onde entram TorchTPU, vLLM, SGLang e llm-d
São camadas diferentes. TorchTPU conecta operações PyTorch ao acelerador. vLLM e SGLang cuidam de servir o modelo e administrar lotes e cache. O llm-d 1.0 atua acima disso: coordena servidores em Kubernetes, encaminha requisições conforme carga e contexto em cache e pode ajudar a separar tráfego interativo de tarefas em lote. É possível começar por uma parte; a própria documentação do projeto descreve componentes que podem ser combinados conforme a necessidade.
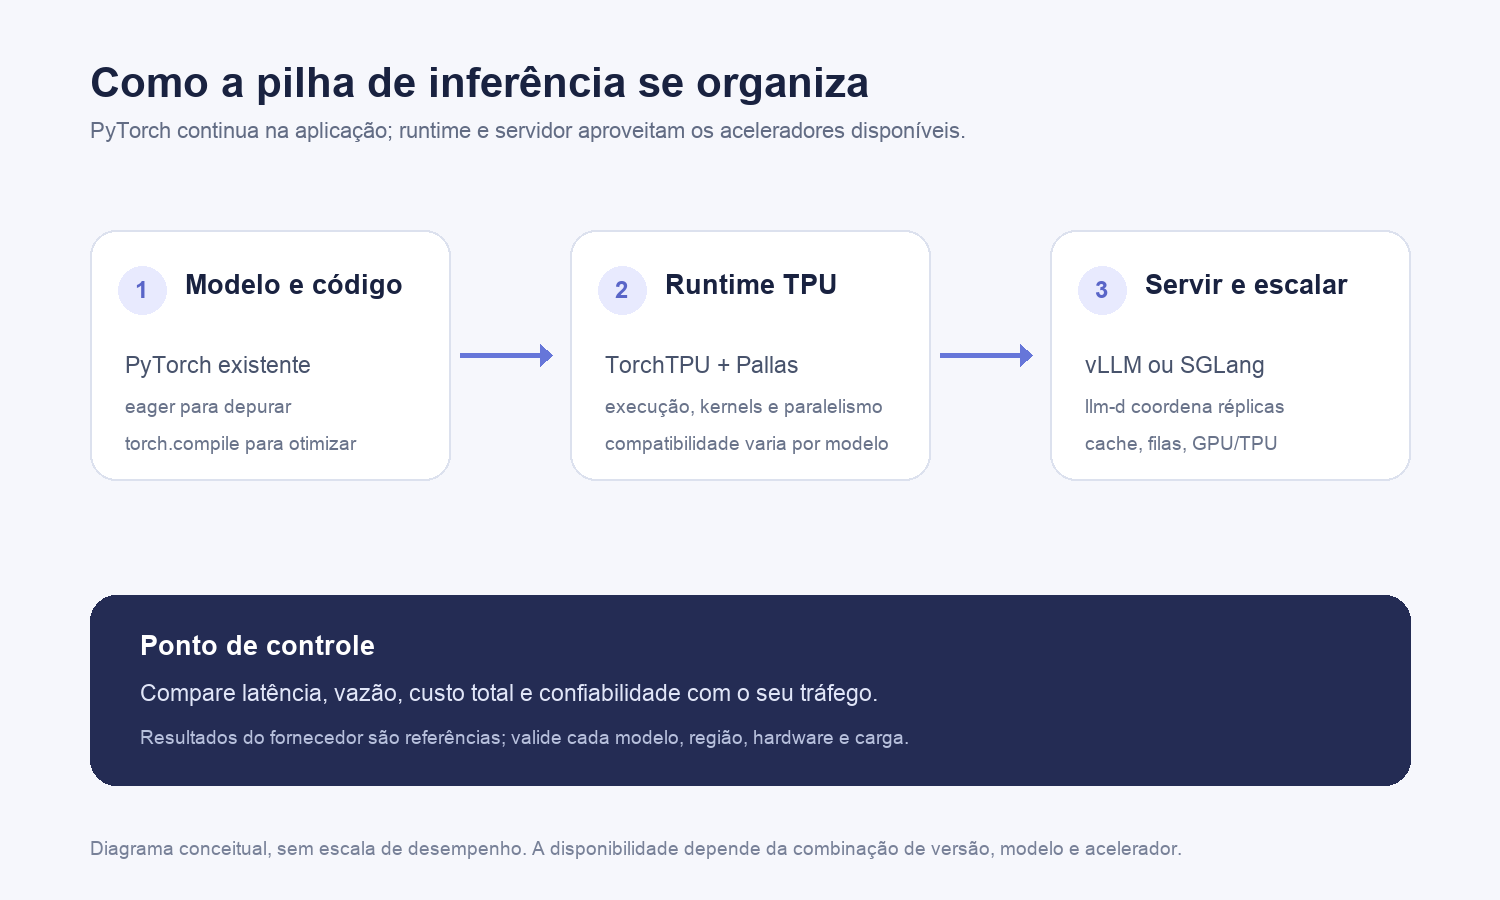
A documentação oficial de PyTorch no Cloud TPU lista a função de cada camada e os modelos e recursos suportados. Ela também confirma que vLLM e SGLang continuam com backends baseados em JAX para quem já usa esse caminho. Portanto, o lançamento adiciona uma opção de execução PyTorch; não exige migrar sistemas existentes.
A página de documentação do Google descreve o vídeo acima como uma visão geral de TorchTPU. Para detalhes de instalação e compatibilidade, consulte também o repositório oficial do projeto, que registra requisitos, exemplos e o estágio de suporte de cada combinação.
Quando isso pode interessar a uma empresa
A notícia é mais relevante para equipes que já executam modelos abertos ou têm uma razão concreta para hospedar inferência: requisitos de controle sobre os modelos, volume recorrente, latência específica ou necessidade de comparar fornecedores de aceleradores. Uma equipe que usa uma API gerenciada e tem custo e qualidade adequados não precisa migrar por causa do anúncio. Operar modelos por conta própria traz responsabilidades de disponibilidade, segurança, atualização e monitoramento que uma API terceirizada absorve em parte.
Um benefício potencial é poder testar um backend de TPU preservando mais da estrutura PyTorch e dos servidores usados hoje. O Google publicou resultados de um workload de agentes de programação no qual roteamento com consciência de cache e offload de memória melhoraram latência e vazão frente a um serviço Kubernetes simples. Esses números são resultados divulgados pelo próprio fornecedor para uma configuração específica; não são garantia de economia em qualquer aplicação, modelo ou região.
O que medir antes de trocar de hardware
Comece com uma única tarefa real e um modelo que apareça na matriz de suporte. A documentação indica que a disponibilidade depende de modelo, versão, acelerador e recursos usados. Também é necessário ter um projeto e cota de Cloud TPU, além de capacidade na região escolhida. Código aberto não significa que o hardware possa ser instalado em qualquer provedor.
Compare o mesmo conjunto de solicitações e condições na infraestrutura atual e no teste. Registre custo total por tarefa concluída, latência mediana e no percentil 95, vazão sob concorrência, qualidade da resposta, falhas e tempo da equipe para operar a solução. Inclua armazenamento de cache, transferência de dados, nós de coordenação e redundância; uma conta apenas de preço por hora do acelerador não mostra o custo completo.
O guia de PyTorch no Cloud TPU ajuda a identificar as dependências do piloto. Antes de ampliar, valide o resultado com tráfego representativo, uma estratégia de retorno à plataforma atual e limites de gasto. Se a demanda for esporádica, uma infraestrutura dedicada pode custar mais do que a simplicidade de uma API.
A decisão continua sendo de produto e arquitetura
O anúncio diminui a distância entre o ecossistema PyTorch e os aceleradores TPU, especialmente para equipes que já servem modelos abertos. O salto para uma frota distribuída com Kubernetes, llm-d e diferentes aceleradores, porém, só faz sentido quando a escala e os requisitos justificam essa operação.
Para negócios avaliando por onde a IA pode entrar no processo, vale começar pelos critérios de uso, revisão e dados em IA generativa nas empresas. Se a avaliação avançar para infraestrutura, o artigo sobre como escolher uma stack de tecnologia ajuda a comparar manutenção, integrações e dependência de fornecedor. A decisão recomendada não é “TPU ou GPU” em abstrato: é qual combinação atende o modelo e o serviço com resultado medido, custo total aceitável e uma equipe capaz de sustentá-la.
